序言
针对并发场景,Java 提供了众多的并发工具类供我们使用,可以按照具体的业务场景选择合适的工具类:
| 工具类 | 核心解决的问题 | 典型业务场景 | 关键词 |
|---|---|---|---|
CountDownLatch |
等多个任务完成继续执行 | 主线程等待多个子任务完成 | 等完成 |
CyclicBarrier |
多个线程互相等待,到齐后一起继续 | 多线程分阶段计算 | 等大家 |
Semaphore |
控制同时访问资源的线程数量 | 限流、连接池、库存资源控制 | 限并发 |
Lock / Condition |
更灵活的线程同步与等待 | 队列、生产者消费者 | 锁 |
Atomic 等 |
无锁线程安全地更新变量 | 计数器、状态更新 | 原子操作 |
CompletableFuture |
异步任务编排 | 并行查询、任务组合、异步回调 | 异步编排 |
BlockingQueue |
线程安全的生产消费队列 | 任务队列、线程池内部队列 | 生产消费 |
计数器——CountDownLatch
CountDownLatch 是一种线程同步工具,用于让一个或多个线程等待一组任务执行完成。
它内部维护一个计数器,创建时指定初始值,每完成一个任务就调用一次 countDown(),计数器减 1;当计数器减为 0 时,所有调用 await() 等待的线程都会继续执行。
1 | 线程A |
CountDownLatch 解决的是:“我要等 N 个事情全部完成之后,再继续往下执行。”
比如我们去游乐园体验激流勇进项目,有的时候游乐园里人不是那么多,这时,管理员会让你稍等一下,等人坐满了再开船,这样的话可以在一定程度上节约游乐园的成本。座位有多少,就需要等多少人,这就是 CountDownLatch 的核心思想,等到一个设定的数值达到之后,才能出发。
流程图
我们把激流勇进的例子用流程图的方式来表示:
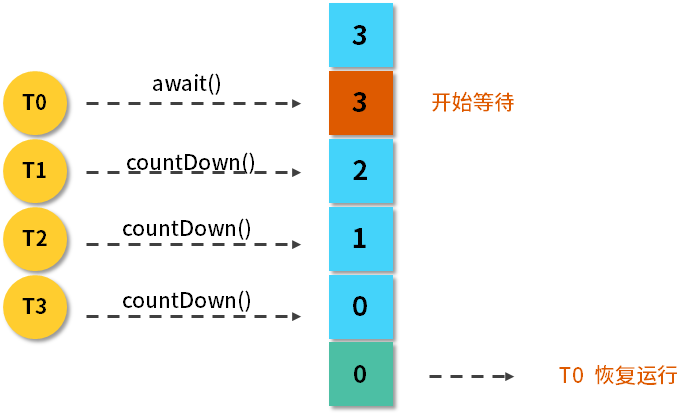
由图可知,最开始 CountDownLatch 设置的初始值为 3,然后 T0 线程上来就调用 await 方法,它的作用是让这个线程开始等待,等待后面的 T1、T2、T3,它们每一次调用 countDown 方法,3 这个数值就会减 1,也就是从 3 减到 2,从 2 减到 1,从 1 减到 0,一旦减到 0 之后,这个 T0 就相当于达到了自己触发继续运行的条件,于是它就恢复运行了。
API
下面介绍一下 CountDownLatch 的主要 API:
- (1)构造函数:
public CountDownLatch(int count) { };:构造函数是传入的 count 参数是需要倒数的数值 - (2)await():调用 await() 方法的线程开始等待,直到倒数结束,也就是 count 值为 0 的时候才会继续执行
- (3)await(long timeout, TimeUnit unit):await() 有一个重载的方法,里面会传入超时参数,这个方法的作用和 await() 类似,但是这里可以设置超时时间,如果超时就不再等待了
- (4)countDown():将 count 值减 1,当 count 被减为 0 时,之前等待的线程会被唤起
业务场景
接着来介绍一下 CountDownLatch 的两个典型用法。
用法一:一个线程等待其他多个线程都执行完毕,再继续自己的工作
在实际场景中,很多情况下需要我们初始化一系列的前置条件(比如建立连接、准备数据),在这些准备条件都完成之前,是不能进行下一步工作的,所以这就是利用 CountDownLatch 的一个很好场景,我们可以让应用程序的主线程在其他线程都准备完毕之后再继续执行。
举个生活中的例子,那就是运动员跑步的场景,比如在比赛跑步时有 5 个运动员参赛,终点有一个裁判员,什么时候比赛结束呢?那就是当所有人都跑到终点之后,这相当于裁判员等待 5 个运动员都跑到终点,宣布比赛结束。我们用代码的形式来写出运动员跑步的场景,代码如下:
1 | public class RunDemo1 { |
在这段代码中,我们新建了一个初始值为 5 的 CountDownLatch,然后建立了一个固定 5 线程的线程池,用一个 for 循环往这个线程池中提交 5 个任务,每个任务代表一个运动员,这个运动员会首先随机等待一段时间,代表他在跑步,然后打印出他完成了比赛,在跑完了之后,同样会调用 countDown 方法来把计数减 1。
之后我们再回到主线程,主线程打印完“等待 5 个运动员都跑完”这句话后,会调用 await() 方法,代表让主线程开始等待,在等待之前的那几个子线程都执行完毕后,它才会认为所有人都跑完了比赛。这段程序的运行结果如下所示:
1 | 等待5个运动员都跑完..... |
可以看出,直到 5 个运动员都完成了比赛之后,主线程才会继续,而且由于子线程等待的时间是随机的,所以各个运动员完成比赛的次序也是随机的。
用法二:多个线程等待某一个线程的信号,同时开始执行
这和第一个用法有点相反,我们再列举一个实际的场景,比如在运动会上,刚才说的是裁判员等运动员,现在换个角度:运动员等裁判员。在运动员起跑之前都会等待裁判员发号施令,一声令下运动员统一起跑,我们用代码把这件事情描述出来,如下所示:
1 | public class RunDemo2 { |
在这段代码中,首先打印出了运动员有 5 秒的准备时间,然后新建了一个 CountDownLatch,其倒数值只有 1;接着,同样是一个 5 线程的线程池,并且用 for 循环的方式往里提交 5 个任务,而这 5 个任务在一开始时就让它调用 await() 方法开始等待。
接下来我们再回到主线程。主线程会首先等待 5 秒钟,这意味着裁判员正在做准备工作,比如他会喊“各就各位,预备”这样的话语;然后 5 秒之后,主线程会打印出“5 秒钟准备时间已过,发令枪响,比赛开始”的信号,紧接着会调用 countDown 方法,一旦主线程调用了该方法,那么之前那 5 个已经调用了 await() 方法的线程都会被唤醒,所以这段程序的运行结果如下:
1 | 运动员有5秒的准备时间 |
可以看到,运动员首先会有 5 秒钟的准备时间,然后 5 个运动员分别都准备完毕了,等待发令枪响,紧接着 5 秒之后,发令枪响,比赛开始,于是 5 个子线程几乎同时开始跑步了。
注意事项
下面来讲一下 CountDownLatch 的注意点:
countDown()必须保证最终执行:其他线程可能永久阻塞在latch.await();,所以实际使用时,countDown()应该放到finally中CountDownLatch不能重复使用:,比如已经完成了倒数,那可不可以在下一次继续去重新倒数呢?这是做不到的,如果你有这个需求的话,可以考虑使用 CyclicBarrier 或者创建一个新的 CountDownLatch 实例await()最好设置超时时间:生产环境中不建议无期限等待,因为某个子任务如果由于异常、死循环、线程池拒绝等原因没有执行countDown(),调用线程就可能一直卡住,所以超时处理更稳妥1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18主线程
│
├── 等待任务A
├── 等待任务B
└── 等待任务C
↓
最多等待10秒
↓
┌─────┴─────┐
↓ ↓
全部完成 超时
继续执行 降级/告警/返回
boolean success = latch.await(10, TimeUnit.SECONDS);
if (!success) {
// 超时处理
}countDown()不代表任务一定成功:CountDownLatch 只负责“等任务结束”,不负责“判断任务是否成功”,所以如果业务需要知道每个任务是否成功,需要额外记录结果或者使用CompletableFuture 机制处理任务结果- 和线程池一起使用时,要特别注意任务是否真的执行:假设提交了 10 个任务,但如果线程池因为:队列满了、线程池已经关闭、拒绝策略触发,导致某些任务根本没有提交成功,那么对应的 countDown() 也不会执行。最终
latch.await();就可能一直等待。所以在实际项目中,需要考虑:任务提交失败时,计数器怎么办?例如提交失败时进行相应的 countDown() 或直接终止这次协调流程。1
2
3
4
5
6
7
8
9
10
11
12
13CountDownLatch latch = new CountDownLatch(10);
for (int i = 0; i < 10; i++) {
executor.submit(() -> {
try {
doSomething();
} finally {
latch.countDown();
}
});
}
latch.await();
小结
CountDownLatch 类在创建实例的时候,需要在构造函数中传入倒数次数,然后由需要等待的线程去调用 await 方法开始等待,而每一次其他线程调用了 countDown 方法之后,计数便会减 1,直到减为 0 时,之前等待的线程便会继续运行。
栅栏——CyclicBarrier
在多线程编程中,有这样一种场景:多个线程分别执行自己的任务,等所有线程都执行到某个阶段之后,再让它们一起继续执行下一阶段。
例如一个批处理系统,需要同时处理 10 个分片的数据:
1 | 线程1 → 处理分片1 ─┐ |
这种场景下,就可以使用 CyclicBarrier。
什么是 CyclicBarrier?
CyclicBarrier 是 JDK 提供的一个线程同步工具。它允许一组线程相互等待:当所有线程都到达某个同步点之后,这些线程才能继续执行。
例如CyclicBarrier barrier = new CyclicBarrier(3);表示需要有 3 个线程到达这个“栅栏”,3 个线程全部到达之后,栅栏才会打开。
使用barrier.await();线程执行到这里之后,就会等待其他线程。
例如:
1 | Thread A Thread B Thread C |
这就是 CyclicBarrier 最核心的功能。
为什么需要 CyclicBarrier?
假设现在有一个大数据批处理任务,一天产生了 1000 万条数据,我们把数据拆成 10 份:
1 | 1000万条数据 |
第一阶段,每个线程分别处理自己的数据。
但是第二阶段要求:必须等第一阶段所有分片都处理完成之后才能开始。
这个时候就可以:
1 | CyclicBarrier barrier = new CyclicBarrier(10); |
整个流程就是:
1 | 线程1:处理数据 ────────┐ |
这就是 CyclicBarrier 非常典型的业务场景。
CyclicBarrier 最典型的特点:可以重复使用
它名字里面有一个非常重要的单词 Cyclic,也就是循环的、可重复使用的。
例如CyclicBarrier barrier = new CyclicBarrier(3);,第一次:
1 | 线程A ─┐ |
如果三个线程继续执行,之后它还可以再次使用:
1 | 线程A ─┐ |
因此特别适合:多线程分阶段执行任务的场景。,比如:
1 | for (int round = 0; round < 10; round++) { |
可以理解成:
1 | 第一轮 |
所以 CyclicBarrier 特别适合多阶段、反复执行的并行任务。
CyclicBarrier 可以设置“栅栏动作”
CyclicBarrier 还有一个比较实用的功能:
1 | CyclicBarrier barrier = new CyclicBarrier(3, () -> { |
例如barrier.await();
当最后一个线程到达栅栏之后,会执行这个 barrierAction。
业务上可以用来做:> 这一阶段所有线程都完成之后,统一执行一个动作。
例如:
1 | CyclicBarrier barrier = new CyclicBarrier(10, () -> { |
那么:
1 | 线程1 ─┐ |
不过这里要注意:barrierAction 并不是一个独立线程池任务。
它是由最后一个到达栅栏的线程执行的。
所以不要在里面放特别耗时的操作,否则可能影响其他线程通过栅栏。
注意事项
① await() 可能一直等待
例如CyclicBarrier barrier = new CyclicBarrier(3);,如果只有两个线程执行:barrier.await();
那么两个线程都会一直等待第三个线程。
因此实际生产环境中可以使用barrier.await(10, TimeUnit.SECONDS);,避免无限等待。
② 一个线程异常可能导致整个栅栏失效
假设:
1 | 线程A → 正常执行 → await() |
如果线程 C 没有正常到达栅栏,A、B 就无法正常完成这一轮协调,CyclicBarrier 对这种情况会通过 broken 状态处理。
因此使用时要考虑:某个参与者异常退出后,其他线程怎么办?
可以结合异常处理、超时机制以及barrier.reset();进行恢复。
③ 参与线程数量必须匹配
例如new CyclicBarrier(10);意味着这一轮需要 10 个线程到达。
如果你的业务实际上只启动了 9 个线程:那么永远差一个线程,其他线程就会一直等。
所以:CyclicBarrier 的参与者数量是设计时必须明确的。
④ 不要在 barrierAction 中执行耗时任务
例如:
1 | new CyclicBarrier(10, () -> { |
因为最后一个到达的线程需要执行这个动作,更适合:
1 | new CyclicBarrier(10, () -> { |
把它控制在比较轻量的范围内。
CyclicBarrier VS CountDownLatch
| CountDownLatch | CyclicBarrier | |
|---|---|---|
| 核心思想 | 等待其他任务完成 | 多个线程相互等待 |
| 谁等待 | 通常是一个线程等待多个任务 | 多个线程相互等待 |
| 是否可以重复使用 | ❌ 不可以 | ✅ 可以 |
| 是否支持分阶段 | 不适合 | 非常适合 |
| 典型场景 | 初始化、批量任务等待 | 多线程分阶段计算 |
| 计数方向 | countDown() 递减 |
await() 到达栅栏 |
| 典型关系 | 我等你们 | 我们互相等 |
小结
如果需要“多个线程需要按照阶段协同推进”,那么可以CyclicBarrier来实现业务。
信号量——Semaphore(了解)
由于在实际的业务开发过程中,一般会使用 Sentinel 框架来控制并发流量,所以简单了解下 Semaphore 即可。
在实际的业务开发中,我们经常会遇到这样一种场景:系统中的资源是有限的,但是同时访问这个资源的线程可能很多。
例如,一个系统只有 10 个数据库连接,但是突然来了 100 个请求。
如果 100 个请求同时访问数据库,就可能把数据库连接池、数据库本身压垮。
这时候我们可能需要一个机制:
1 | 100个请求 |
这就是 Semaphore 主要解决的问题:> 限制同时访问某个资源的线程数量。
简介
Semaphore 是 JDK 提供的一个信号量工具类,用于控制同时访问某个资源的线程数量。
例如Semaphore semaphore = new Semaphore(10);表示:最多允许 10 个线程同时获得许可。
代码示例
- 线程访问资源之前通过
semaphore.acquire();获取一个许可。 - 使用完资源之后
semaphore.release();释放一个许可。
完整代码:
1 | Semaphore semaphore = new Semaphore(10); |
可以简单理解成:
1 | Semaphore(10) |
因此 Semaphore 的核心不是“加锁”,而是 控制并发访问数量。
为什么需要 Semaphore?
假设现在有一个文件处理服务。
服务器上有一个非常昂贵的 PDF 转换服务,同时最多只能允许 5 个任务进行转换。
现在来了 100 个任务都需要PDF转换服务
如果全部直接执行 100 个任务,同时访问PDF服务,那么 CPU、内存、IO 压力暴增,可以导致服务响应变慢甚至崩溃。
那么可以使用Semaphore semaphore = new Semaphore(5);
然后:
1 | try { |
最终变成通过下面的流程控制控制,把并发量限制在 5。:
1 | 100个任务 |